Our last blog post introduced the distinction between AI models that use language to understand what you’re saying and models that get the ‘gist’ of your speech. In today’s post, we’ll dig into the latter.
"好的,电脑"
如今,我们都熟悉与语音人工智能交互的主要方式:触发短语。"嘿 Siri "和 "嘿 Alexa "已成为我们日常生活的一部分。
提出这种方法的人试图解决两个问题:首先,他们需要一种明确的方法来确定用户何时在向人工智能发号施令;其次,他们需要人工智能始终响应性地、高效地聆听指令,而这需要人工智能的大量马力。"好的,电脑 "并不是一种自然语言模式,但使用人工智能却很容易实现;理想情况下,我们应该能够像对智能人类助手一样对人工智能说话,相信它们会根据上下文知道我们什么时候在说话,而不仅仅是当我们明确说出它们的名字时才知道。创建关键词触发器是为了规避人工智能和电源方面的限制,但现在这些限制已不再适用。
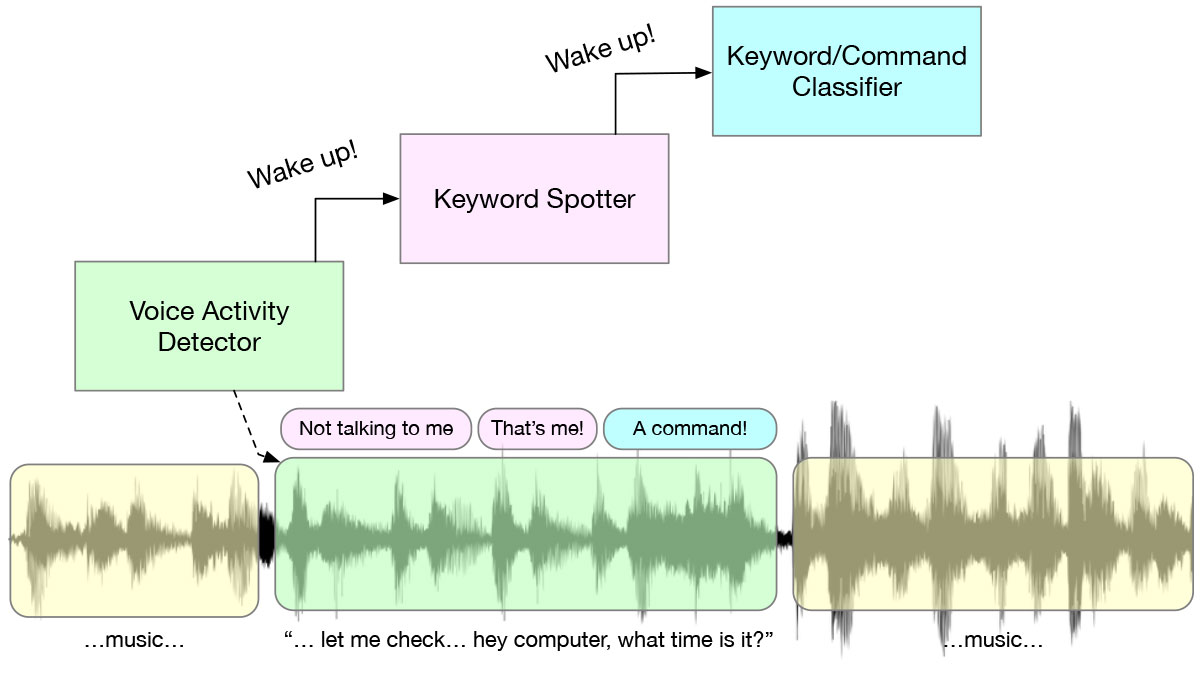
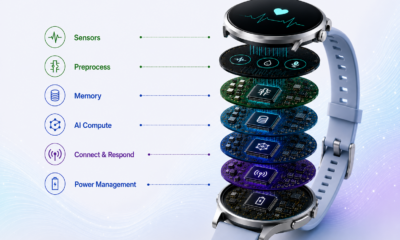
当你说出一个关键字时,在幕后发生的是一个有趣的多级唤醒系统,这是一系列旨在省电的算法和人工智能模型。从一直在监听的语音活动检测器(VAD)开始,当出现任何语音时,KWS 模型就会被触发,并检测语音是否是预定义的关键词,例如 "嘿,Alexa"。只有在这一切发生后,才会进行更复杂的处理。这种级联是为了提高能效-在每个阶段,都尽可能执行要求最低的算法。
"当你只有一把锤子……"
有很多神经网络方法可以发现关键词,但(至少对我来说)最有趣的方法是基于识别频谱特征。频谱图是音频转换成频域的图片,而人工智能非常擅长对图片进行分类。要训练人工智能图像分类模型识别猫,就需要展示大量猫的图片。训练关键词识别器在概念上是一样的:记录数千个人们说这句话的例子,计算每个例子的频谱图(基本上是一幅图像),然后训练模型来识别这些图像。
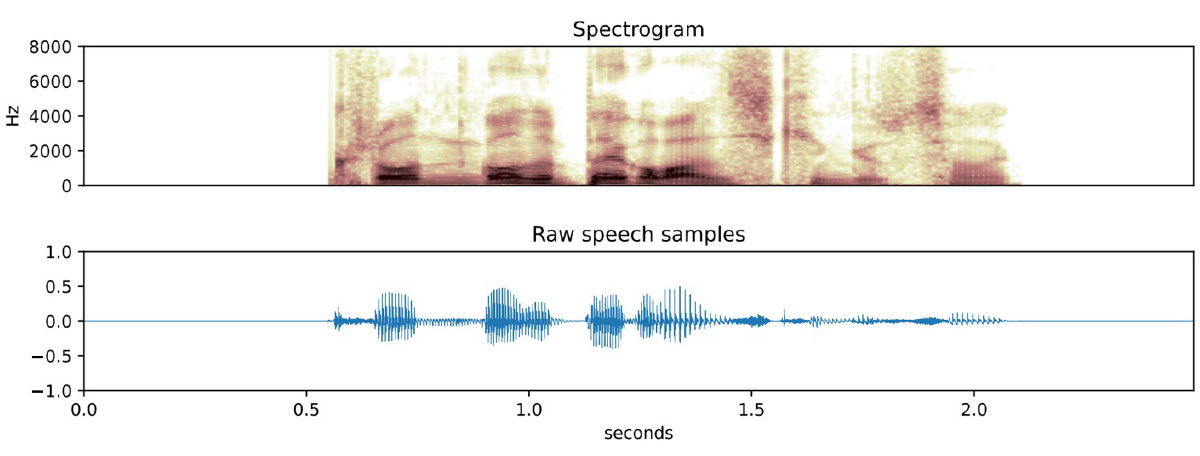
这种方法有其局限性,最重要的一点是音频不能太长。频谱图捕捉的是音频片段在固定时间内的频率,如果时间太长,响应速度和准确度都会下降。这意味着这种方法适用于两到五秒钟的短语,但不适用于需要较长句子的任务。
图像分类是最古老、最易理解的人工智能任务之一,因此利用该类算法是很有意义的。图像分类的许多特性同样适用于音频。最有用的是,神经网络的设计可以将 "模式匹配 "与 "被匹配模式 "分开学习,这实际上意味着使用迁移学习来教授人工智能一个新的短语,而不是从头开始。
"按我的意思去做,而不是按我说的去做"
事实证明,一旦你开始把音频当作图像处理,你就可以训练人工智能做更多的事情,而不仅仅是简单的唤醒词。下一个合乎逻辑的步骤是在许多指令词上训练你的模型,这些指令词可以用来创建简单的用户界面,就像你说 "导航 "来打开汽车导航系统一样。
事实上,我们能做的远不止简单的命令。有些模型可以从说话短语中推断出说话者的意图。这些 "从语音到意图"(Speech-to-Intent)模型是在几十个短语的成千上万种变化中训练出来的,可以归纳出从未听过的变化。这些模型对于创建基于语音的用户界面非常有用,最终让设备摆脱了通常的固定短语界面。
实际问题
Apollo4, with its ultra-low-power, 192Mhz performance, hyper-efficient audio peripherals, 2MB MRAM, generous cache, and large tightly-coupled-memory, is very well suited to running AI models such as KWS and speech-to-intent. Model sizes vary depending on the number of keywords or intents but generally fit in under 200KB of RAM and sip around 500 uJ per inference. Inference latency is not a factor at all, being well under the phrase length - KWS takes about 50ms, for example.
基于深度语言模型的语音识别技术还比较遥远,不过算法和设备方面的稳步发展将在未来一两年内使其成为现实。
圣杯
如上文所述,大多数基于人工智能的语音用户界面都很笨拙,是根据工程限制而非用户需求设计的,导致 Alexa 或 Siri 用户只能使用 "启动计时器 "和 "提高音量 "等老生常谈的简单命令。
总有一天,对着手表说话会和对着人说话没什么区别:你的设备会根据各种上下文信息,知道你是在对它说话,还是在对一个人说话,它不会要求你记住几个关键短语,而是像一个优秀的个人助理那样,学会读懂你的意图。