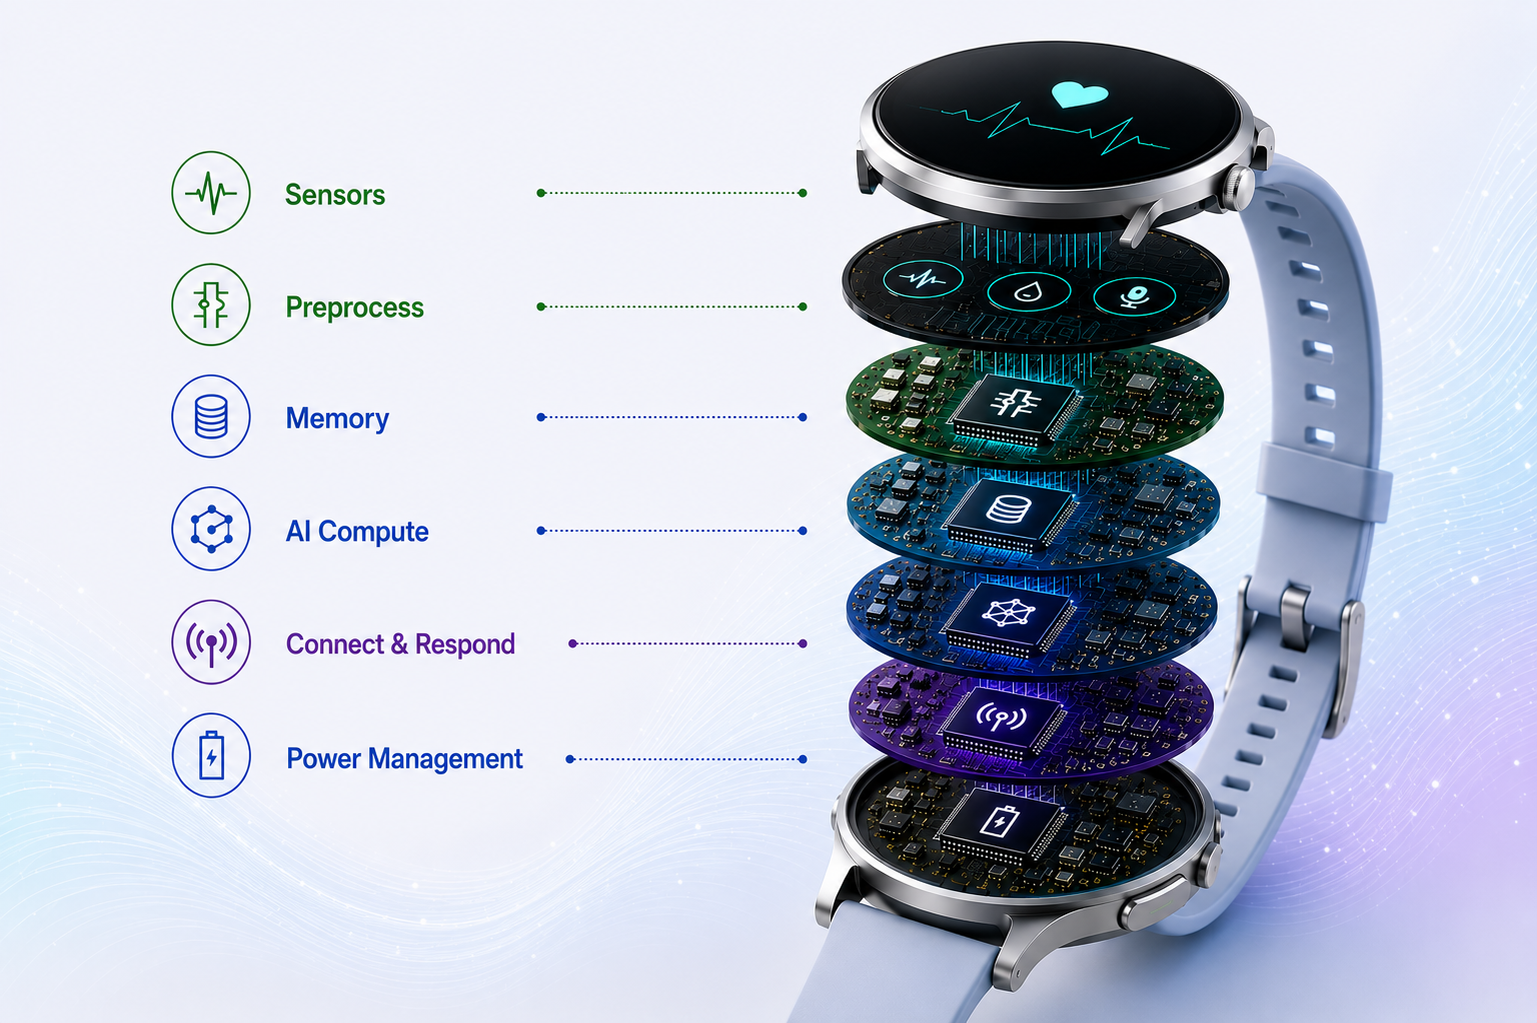
穿戴式裝置正變得越來越智慧,但其電池容量卻並未以相應的比例增加。
從健康監測和活動辨識,到全天候語音功能及新興的人工智慧助理,人們對穿戴式裝置的期待日益提高,期望它們能即時感知、解讀並回應周遭環境。此外,越來越多的智慧功能正轉移至裝置端,不僅降低了對雲端連線的依賴,同時也提升了反應速度並加強了隱私保護。
但每一項額外的工作負荷,都會與其他任務爭奪這有限的能量儲備。
這改變了產品與工程團隊在評估適用於超低功耗穿戴式裝置的邊緣 AI 晶片時應採取的方式。AI 峰值效能固然重要,但這僅是其中一項考量因素。對於電池供電的裝置而言,更關鍵的問題是:
在現有的功耗預算範圍內,該系統能提供多少智慧處理能力?
在評估適用於超低功耗穿戴式裝置的邊緣 AI 晶片時,應優先考量整體系統功耗、與工作負載相符的節能運算能力、記憶體與資料傳輸效率、動態功耗調整、持續感測功能,以及能讓硬體實際部署的 AI 軟體堆疊。僅憑 AI 峰值效能並不能決定電池續航力。
1. 不要只關注 TOPS,而應著眼於整體系統效能
人工智慧處理器通常會透過 TOPS 或 GOPS 等峰值效能指標進行比較。這些數值雖有助於描述運算能力,但未必能反映穿戴式裝置的實際運作方式。
大多數穿戴式裝置並未持續執行其最耗資源的人工智慧工作負載。
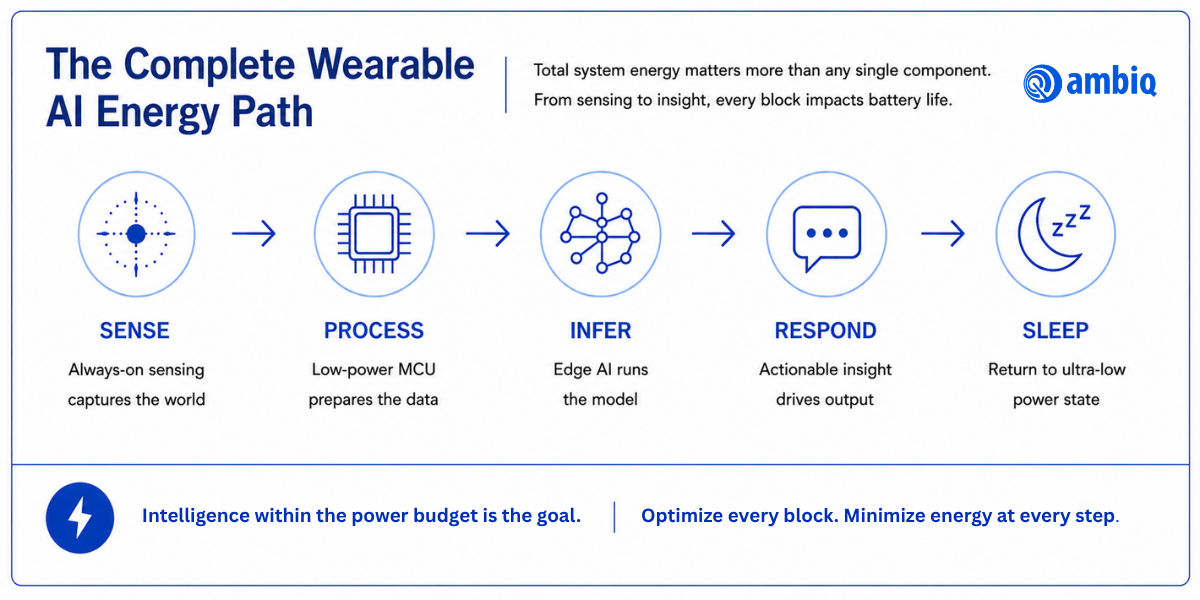
某個裝置在其生命週期的絕大部分時間裡,可能會以極低的功耗監控感測器,並定期喚醒以處理資料;當發生具有意義的事件時執行推論,傳輸結果,然後再返回低功耗狀態。
這使得整個運作週期所消耗的能源,比單一的加速器基準測試更為重要。
在比較邊緣 AI 硬體時,產品團隊應考量系統處理以下事項的效率:
- 持續感測
- 訊號預處理
- 記憶體存取與資料移動
- AI 推論
- 連接
- 低功耗狀態與高性能狀態之間的轉換
目標並非僅僅是將推論效能降至最低,而是要在維持所需使用者體驗的同時,將系統總能耗降至最低。
這種系統層級的作法,正是 AmbiqSPOT®(亞閾值功耗優化技術)平台的核心。SPOT 並非將低功耗視為針對個別工作負載所進行的優化,而是旨在於半導體層級上,降低智慧型終端裝置所需所有功能的能源消耗。
對穿戴式裝置設計師而言,這項區別至關重要。AI 的能源效率,始於 AI 底層的架構。
2. 將 AI 硬體與工作負載相匹配
專用的神經網路處理能力能顯著加速人工智慧工作負載。但這並不代表每款可穿戴式人工智慧應用程式都需要讓 NPU 持續運作——甚至未必需要 NPU。
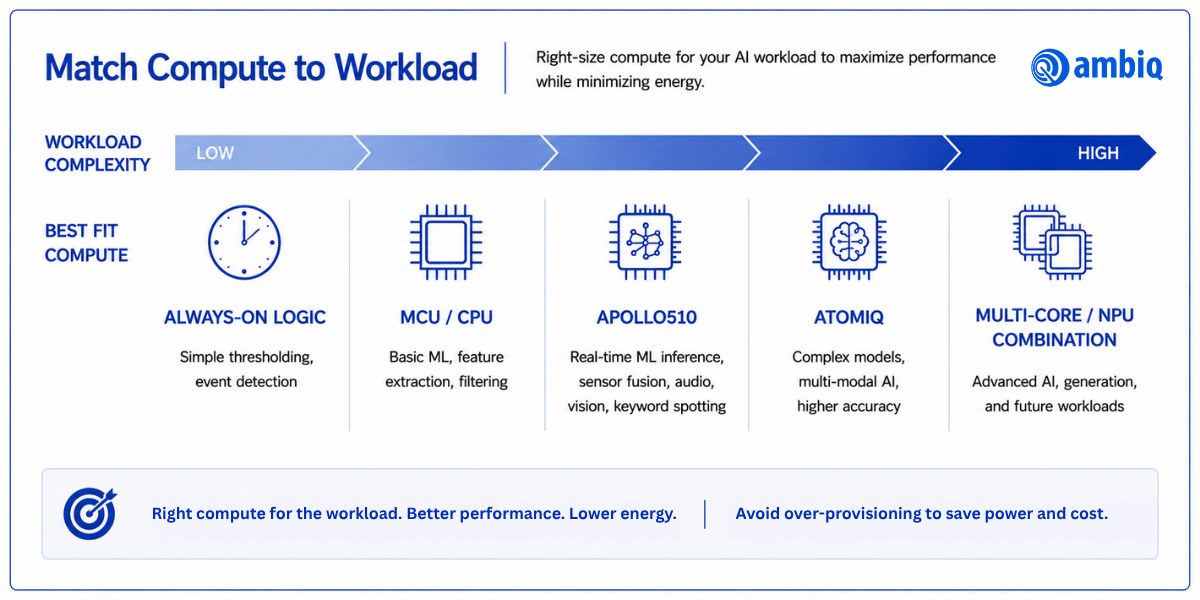
許多持續運行的應用程式涉及相對精簡的工作負載:感測器分類、關鍵字偵測、動作辨識、異常偵測,以及其他形式的持續監控。
對於這些應用,更恰當的問題並非:
這顆晶片有 NPU 嗎?
是:
對於這項特定工作負載而言,哪種運算資源的能源效率最高?
這意味著應評估整個運算架構,而非僅聚焦於單一加速器。
Ambiq 的Apollo510正是這種做法的典範。Apollo510 以搭載 Helium™ 技術的 Arm® Cortex®-M55 處理器為核心,並結合 Ambiq 的 SPOT 平台,其設計旨在無需專用 NPU 的情況下,執行廣泛的 AI 工作負載,包括低功耗感測器監控與持續運作的語音應用程式。
對於產品團隊而言,將運算架構與工作負載相匹配,有助於避免將能源和矽資源浪費在應用程式不需要的效能上。
隨著模型的要求日益提高,專用的 AI 加速技術也變得愈發重要。因此,該架構需要一條能夠有效擴展的途徑。
3. 觀察功耗如何隨工作負載而變化
穿戴式運算本質上是動態的。某款裝置在監控輸入時可能只需極少的電力,但在處理事件時則需要顯著更多的電力,而執行複雜的人工智慧工作負載時,又需要另一層次的效能表現。
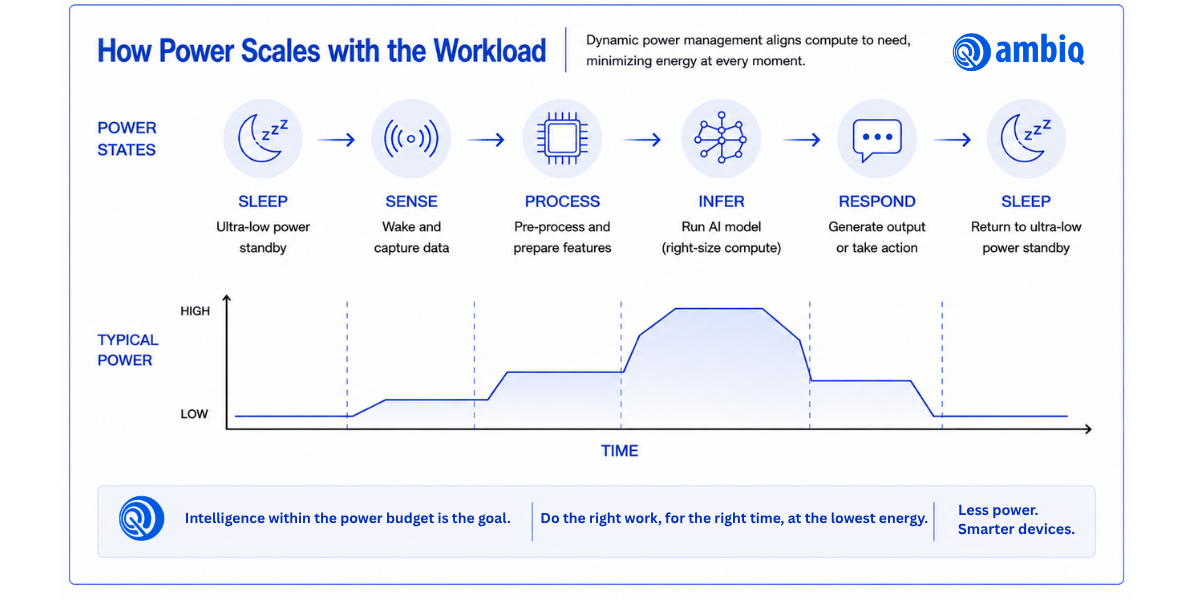
一種針對單一工作點進行優化的架構,在這些過渡過程中可能效率低下。
對於超低功耗的可穿戴裝置而言,硬體應能根據工作負載來調整效能——進而調整能耗。
Ambiq 的 SPOT 架構正是基於此原則所建構。諸如turboSPOT®等技術,能在工作負載需求增加時提供更高的處理效能,同時維持專為超低功耗運作而設計的架構。隨著可穿戴式 AI 工作負載的擴展,此原則的重要性更顯突出。
Ambiq 的下一代Atomiq™架構將其超低功耗設計理念延伸至專用神經網路處理領域。Atomiq 結合 SPOT 技術與 Arm® Ethos™-U85 NPU,可提供超過 200 GOPS 的人工智慧運算效能。 其動態電壓與頻率調整架構專為涵蓋超低功耗、低功耗及高性能運作模式而設計,其中包含一種專為在接近 300 mV 的電壓下運作而設計的超低功耗模式。
重點不僅在於處理器能否快速運作,或是能以極低的功耗運作。
關鍵在於,當工作負載發生變化時,該架構能否在這些運作點之間高效地切換。
對於始終處於運作狀態的人工智慧而言,這些轉換對電池續航力的影響,可能與推論本身的效率同樣重要。
4. 切勿忽視記憶體與資料移動
在討論人工智慧晶片的能源效率時,運算往往成為焦點。但執行運算僅是能源方程式的一部分,資料還必須傳輸到那裡。
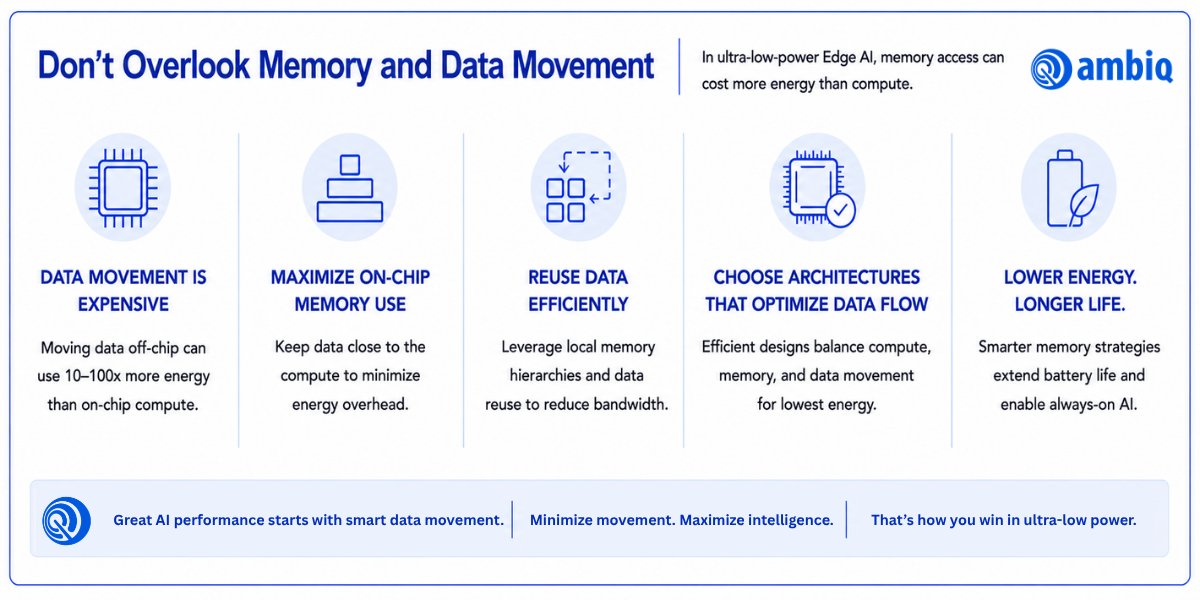
模型權重、感測器輸入、中間激活值及應用資料會持續在記憶體與運算資源之間傳輸。這些傳輸會消耗能量。若記憶體架構效率不佳,資料傳輸可能會抵銷部分由專用 AI 處理所帶來的好處。
因此,產品與工程團隊不應僅著眼於運算規格,還應檢視:
- 可用片上記憶體
- 記憶體頻寬
- 模型與權重儲存
- 資料保留
- 記憶體存取模式
- 記憶體與運算資源的鄰近性
模型規模越大、結構越複雜,這些考量就越顯重要。
這點對穿戴式裝置而言尤為重要,因為增加外部記憶體可能會提高功耗、成本、電路板佔用空間以及系統複雜度。
因此,高效的裝置端人工智慧不僅在於高效地執行運算,更在於減少傳輸與儲存運算所需數據所消耗的能源。
5. 將「持續感測」功能整合至 AI 架構中
許多可穿戴式人工智慧體驗,早在神經網路開始運作之前便已展開。
某個裝置在等待有意義的事件發生之際,可能會持續監測動作、聲音、生理訊號、環境輸入或其他感測器資料流。
若為這些任務持續運行最高效能的處理資源,將迅速削弱邊緣 AI 在電池續航力方面的優勢。
相反地,超低功耗架構應能讓裝置僅保持執行特定任務所需的資源處於活躍狀態。
輕量級的感測與處理可在系統維持低功耗狀態的同時進行。當某個事件需要更複雜的處理時,系統可啟動額外資源,執行相關作業,然後再恢復至低功耗模式。
這種分層式方法對於穿戴式運算而言尤為重要,因為「始終開啟」並不一定意味著必須以最高效能運作。
能夠在極低功耗下執行有用的工作——並在需要時有選擇地擴展運算能力——是讓「持續智能」在小型電池供電裝置上得以實際應用的關鍵。
6. 綜合評估硬體與軟體
唯有當開發者能有效運用高效能矽晶片的性能時,它才能創造價值。
邊緣 AI 的部署不僅僅是讓神經網路運行這麼簡單。工程團隊需要轉換模型、針對資源受限的硬體進行優化、分析效能與記憶體使用情況、整合實際的感測器處理流程,並釐清系統的能源消耗點。
因此,人工智慧軟體堆疊應從一開始就納入矽晶片評估的範圍。
Ambiq 的 neuralSPOT® SDK 正是基於這種硬體與軟體的互動關係而設計。它提供了一個開源、即時且與作業系統無關的環境,用於在 Apollo SoC 上開發、部署、調校及分析 AI 模型。
對於工程團隊而言,這有助於縮短從開發環境中運行的模型到超低功耗終端上優化實作之間的過程。
它還實現了一項在邊緣 AI 中日益重要的功能:協同優化。
開發人員無需分別對模型和晶片進行優化,而是可以評估模型架構、量化、記憶體使用率、處理資源以及運作模式在目標硬體上如何相互作用。
在空間極度受限的可穿戴裝置中,這些互動至關重要。
模型架構或記憶體行為的微小改變,對整體能耗的影響,可能比人工智慧峰值效能的顯著提升還要大。
7. 選擇一種能隨著邊緣 AI 發展而擴展的架構
可穿戴人工智慧的需求正迅速演變。
今天的裝置可能需要進行活動分類或關鍵字偵測;明天的裝置則可能結合多種感測器,並具備更完善的音訊處理、電腦視覺、自然語言介面,或是功能日益強大的裝置端人工智慧模型。
這並不意味著每項產品都應該從現有的最大型 AI 加速器開始著手。這意味著底層平台需要留有擴展的空間。
Ambiq 的產品組合正是這項進展的寫照。
Apollo SoC 為嵌入式與邊緣 AI 工作負載提供了超低功耗的基礎架構。 Apollo510 透過更高效能的處理能力,進一步擴展了這項能力,以因應日益複雜的人工智慧應用,且在許多應用場景中無需額外配置 NPU。
對於能從大幅提升的專用神經網路處理能力中受益的工作負載,Ambiq 即將推出的 Atomiq 系列進一步擴展了該架構,在保留 SPOT 作為其超低功耗基礎的同時,新增了 NPU 加速功能。
這為邊緣 AI 運算創造了一個連續體,而非「一刀切」的解決方案。
對穿戴式裝置設計師而言,這使得他們能夠根據應用程式的實際需求來選擇架構,而非為了那些鮮少使用的效能,而自動承擔不必要的功耗與系統成本。
比較穿戴式裝置用邊緣 AI 晶片時應考慮的問題
規格參數雖有助於篩選出候選名單,但產品與工程團隊在評估適用於超低功耗穿戴式裝置的邊緣 AI 晶片時,應超越規格參數的範圍進行評估。
目標是了解每種架構在實際裝置將面臨的條件下會如何運作。
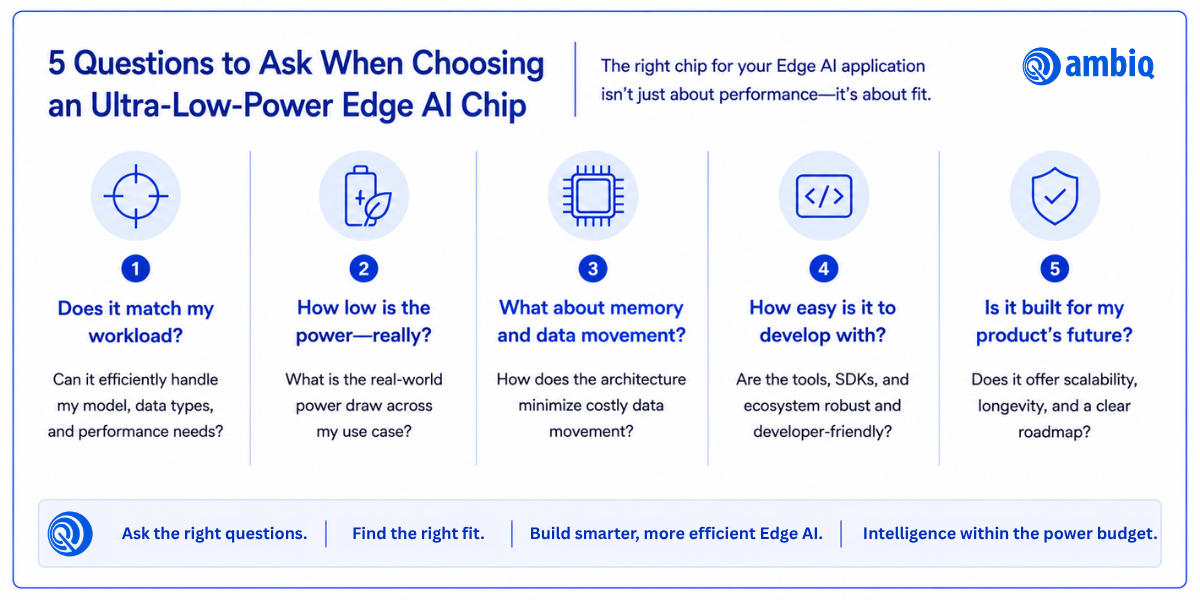
整個工作負載的能源成本是多少?
請向供應商索取包含感測、預處理、記憶體存取、AI 推論、後處理以及運作狀態轉換等環節在內的測量數據。
令人印象深刻的加速器基準測試結果,未必代表穿戴式裝置的整體功耗會因此降低。
關鍵問題在於,整個應用程式在其實際工作週期內消耗多少能量。
該應用程式真的需要 NPU 嗎?
對於要求足夠高的神經網路工作負載而言,NPU 能夠展現極高的效能。然而,在無需專用運算能力時仍添加或啟用專用運算功能,可能會導致系統複雜度不必要地增加。
評估哪些工作負載能在 CPU 或其他可用運算資源上高效運行,以及在哪些情況下,專用的神經網路處理能帶來顯著的效能或能效優勢。
就可穿戴人工智慧而言,答案應取決於工作負載,而非規格表中是否列有加速器。
該架構在不同電源狀態間切換的效率如何?
穿戴式裝置很少能持續以最佳效能運作。
請詢問處理器在需要時能多快、多有效地提升效能,以及在任務完成後能多快、多有效地恢復至低功耗狀態。
對於始終處於開啟狀態的裝置而言,這些狀態轉換過程中消耗的能量可能會影響整體電池使用時長。
傳輸和儲存資料會消耗多少能源?
人工智慧基準測試往往著重於運算能力,卻忽略了記憶體。
請詢問模型權重、感測器資料及中間結果是如何在系統中流動的,以及常用資料是否能保持在需要這些資料的處理資源附近。
隨著模型規模不斷擴大,記憶體架構與資料傳輸可能會逐漸成為影響人工智慧總能耗的重要因素。
開發人員能否在硬體上對實際模型進行測試和效能分析?
相較於通用基準測試,具代表性的工作負載能提供更有用的資訊。
工程團隊應能利用與目標產品相符的模型和感測器處理流程,來評估模型的延遲、記憶體使用率、運算使用率以及功耗表現。
基準測試與最終應用越接近,其結果就越具參考價值。
隨著 AI 需求變化,該平台能否隨之擴展?
當今的穿戴式裝置可能需要進行感測器分類或關鍵字偵測。未來世代的裝置則可能新增多模態感測、更豐富的音訊與視覺功能、自然語言介面,或是更先進的裝置端模型。
請問這種架構是否能在不背離當初使該裝置得以實現的能源效率原則的前提下,提供一條提升人工智慧效能的實用途徑?
這些問題綜合起來,將比較對象從:
哪款晶片的 AI 數值最高?
收件人:
哪種架構能最有效率地執行我的應用程式?
對於超低功耗的可穿戴式人工智慧而言,這才是更貼切的比較。
測試工作負載,而不僅僅是基準測試
規格表應有助於縮小潛在晶片的選項範圍。最終的選擇應依據實際工作負載來決定。
在選擇邊緣 AI 平台之前,應使用具代表性的模型、感測器輸入、取樣率、記憶體需求及運作模式對其進行測試。
測量完整的路徑:
感知 → 預處理 → 傳輸資料 → 推斷 → 回應 → 休眠
與其單獨測量推論延遲或加速器的功耗,這種方法能更真實地反映穿戴式裝置的功耗狀況。
它還能揭露那些從規格表上無法顯而易見的瓶頸。
加速器或許能極其高效地執行神經網路,但前處理、記憶體傳輸或系統喚醒時間卻佔了總能耗的相當大比例。
因此,最優秀的架構未必就是能在某項孤立的人工智慧基準測試中勝出的那個。
這是能以最高效率處理完整應用程式工作負載的那個。
真正的基準:在功耗預算內的智慧表現
下一代穿戴式裝置的定義,不會僅取決於工程師能將多少人工智慧運算能力整合到手腕、手指、耳朵或身體上。
這將取決於他們能在有限的能量下提供多少有用的情報。
因此,在為超低功耗穿戴式裝置選配邊緣 AI 晶片時,整體系統功耗、工作負載感知運算、高效的記憶體調度、持續運作的感測功能、動態效能擴展,以及軟硬體協同優化,皆成為至關重要的考量因素。
Ambiq 從電源架構層面著手解決這個問題。
其 SPOT 平台 提供了超低功耗的基礎架構。 Apollo 將這項高效能技術應用於穿戴式裝置級的邊緣運算。 neuralSPOT 為開發者提供工具,用以針對該硬體建構並優化 AI 工作負載。隨著模型對專用 AI 效能的需求日益增加, Atomiq 將這套超低功耗理念延伸至基於 NPU 的架構中。
對於穿戴式產品及工程團隊而言,關鍵要點很明確:
不要一開頭就問晶片能提供多少人工智慧效能。應從裝置的能源預算著手——並探討在該預算範圍內,該架構能提供多少智慧能力。
對於始終處於運作狀態、由電池供電的邊緣 AI 而言,這正是至關重要的基準。