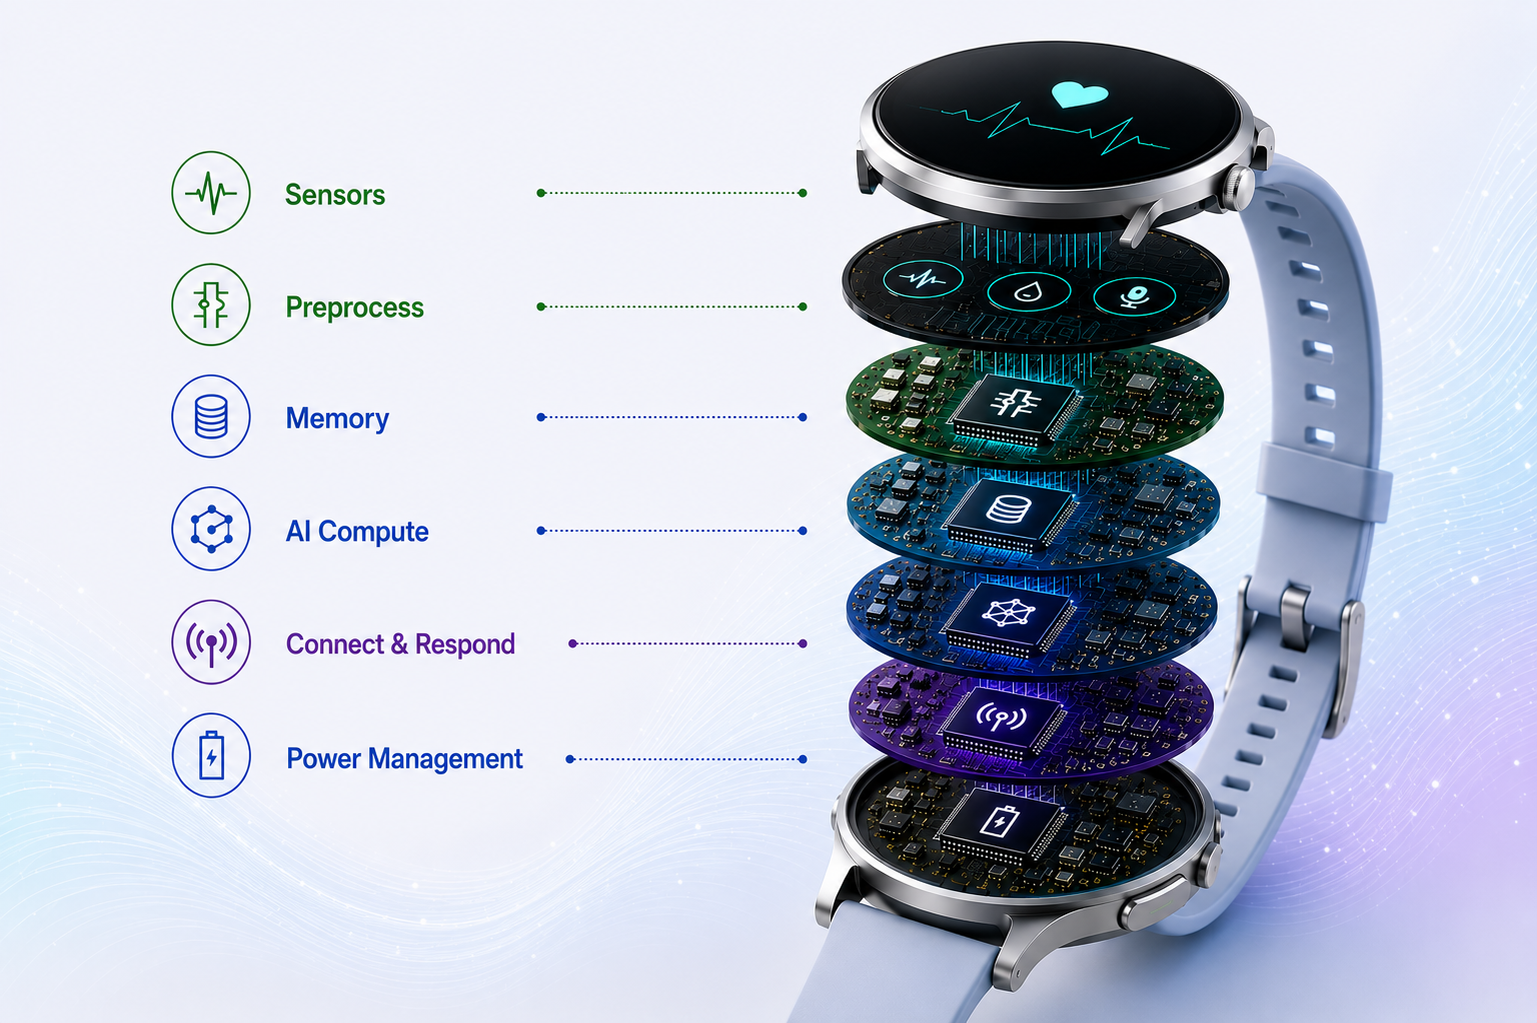
ウェアラブルデバイスはますますスマートになっていますが、そのバッテリーの容量はそれに比例して増えているわけではありません。
健康状態のモニタリングや活動量の認識から、常時稼働の音声機能や新たなAIアシスタントに至るまで、ウェアラブルデバイスには、周囲の状況をリアルタイムで感知・解釈し、それに対応することがますます求められるようになっています。また、そのインテリジェンスの多くがデバイス側に移行しつつあり、クラウド接続への依存度を低減させると同時に、応答性とプライバシーを向上させています。
しかし、追加される作業負荷ごとに、同じ限られたエネルギー予算を奪い合うことになります。
そのため、製品チームやエンジニアリングチームが、超低消費電力のウェアラブル機器向けエッジAIチップを評価する際の基準が変わってきます。AIのピーク性能も重要ですが、それはあくまで一つの要素に過ぎません。バッテリー駆動のデバイスにとって、より重要な問いとなるのは次の通りです:
このシステムは、利用可能な電力バジェットの範囲内で、どの程度のインテリジェンスを発揮できるか?
超低消費電力のウェアラブル機器向けエッジAIチップを評価する際は、システム全体の消費電力、ワークロードに合わせたエネルギー効率の高い演算処理、メモリおよびデータ転送の効率、動的な電力スケーリング、常時稼働のセンシング機能、そしてハードウェアの実用的な導入を可能にするAIソフトウェアスタックを優先すべきです。AIのピーク性能だけで、バッテリー寿命が決まるわけではありません。
1. TOPSだけでなく、システム全体の消費電力に注目する
AIプロセッサの比較には、TOPSやGOPSなどのピーク性能指標がよく使用されます。これらの数値は演算能力を把握する上で役立ちますが、必ずしもウェアラブルデバイスの動作状況を反映しているわけではありません。
ほとんどのウェアラブルデバイスは、最も負荷の高いAIワークロードを継続的に実行しているわけではありません。
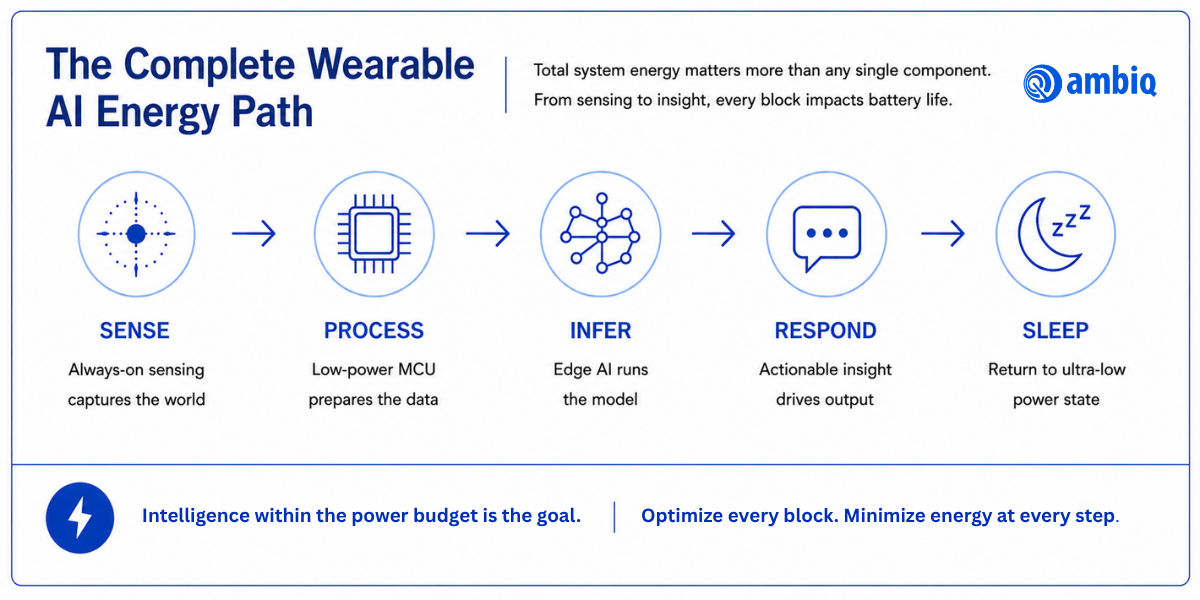
デバイスは、その稼働時間の大部分を、極めて低い消費電力でのセンサー監視に費やし、定期的に起動してデータを処理し、何か有意の事象が発生した際に推論を実行し、その結果を通信した後、再び低消費電力状態に戻る、というサイクルを繰り返して過ごす場合があります。
そのため、アクセラレータ単独のベンチマークよりも、動作サイクル全体で消費されるエネルギーの方が重要となります。
エッジAIハードウェアを比較する際、製品チームは、システムが以下の処理をどれほど効率的に行えるかを検討すべきです:
- 常時稼働のセンシング
- 信号の前処理
- メモリアクセスおよびデータ移動
- AI推論
- コネクティビティ
- 低消費電力状態と高性能状態の切り替え
その目的は、単に推論電力を最小限に抑えることだけではありません。必要なユーザー体験を確保しつつ、システム全体のエネルギー消費を最小限に抑えることにあります。
このシステムレベルのアプローチこそが、AmbiqのSPOT®(サブスレッショルド電力最適化技術)プラットフォームの中核をなすものです。SPOTは、個々のワークロードに適用する最適化として低消費電力を扱うのではなく、インテリジェントなエンドポイントデバイスが必要とするすべての機能において、半導体レベルでエネルギー消費を削減するように設計されています。
ウェアラブル機器の設計者にとって、この違いは重要です。AIのエネルギー効率は、AIを支えるアーキテクチャから始まります。
2. AIハードウェアをワークロードに合わせて最適化する
専用のニューラル処理により、AIワークロードを大幅に高速化することができます。しかし、だからといって、すべてのウェアラブルAIアプリケーションにおいて常時稼働のNPUが必要なわけではありませんし、そもそもNPU自体が必要ない場合もあります。
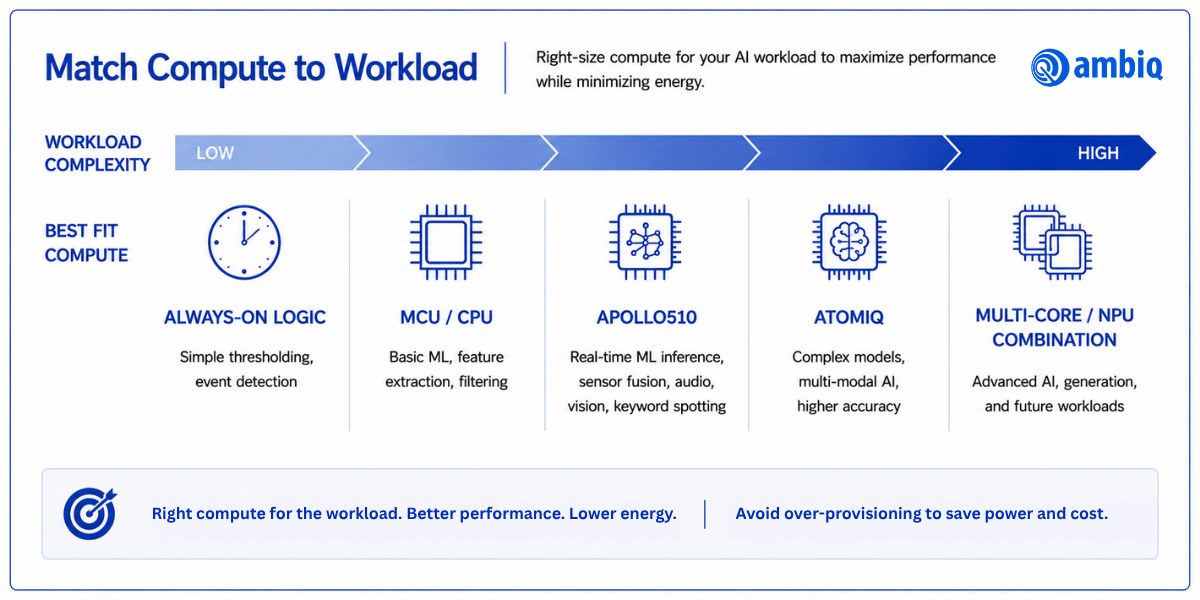
常時稼働のアプリケーションの多くは、センサーの分類、キーワード検出、動作認識、異常検知、その他の継続的な監視など、比較的コンパクトなワークロードを扱っています。
これらの用途において、より適切な問いは次のようなものではありません:
このチップにはNPUが搭載されているか?
適切な問いは:
この特定のワークロードにとって、最もエネルギー効率の高いコンピューティングリソースはどれか?
つまり、単一のアクセラレータに焦点を当てるのではなく、コンピューティングアーキテクチャ全体を評価する必要があるということです。
AmbiqのApollo510は、このアプローチを実証する製品です。Helium™テクノロジーを搭載したArm® Cortex®-M55プロセッサとAmbiqのSPOTプラットフォームを基盤に構築されたApollo510は、専用のNPUを必要とせずに、低消費電力のセンサー監視や常時稼働の音声アプリケーションなど、幅広いAIワークロードを実行できるよう設計されています。
製品開発チームにとって、コンピューティングアーキテクチャをワークロードに合わせて最適化することで、アプリケーションに不要なパフォーマンスのためにエネルギーやシリコンリソースを無駄に消費することを防ぐことができます。
モデルの要求がより厳しくなるにつれ、専用のAIアクセラレーションの価値はますます高まっています。そのため、アーキテクチャには、効果的に拡張できる道筋が必要です。
3. ワークロードに応じた消費電力の変動を確認する
ウェアラブルコンピューティングは、本質的に動的なものです。デバイスは、入力を監視している間はごくわずかな電力しか必要としないかもしれませんが、一方で、イベントを処理する際にはかなり多くの電力を必要とし、さらに複雑なAIワークロードを実行する際には、また別のレベルの性能が求められる場合があります。
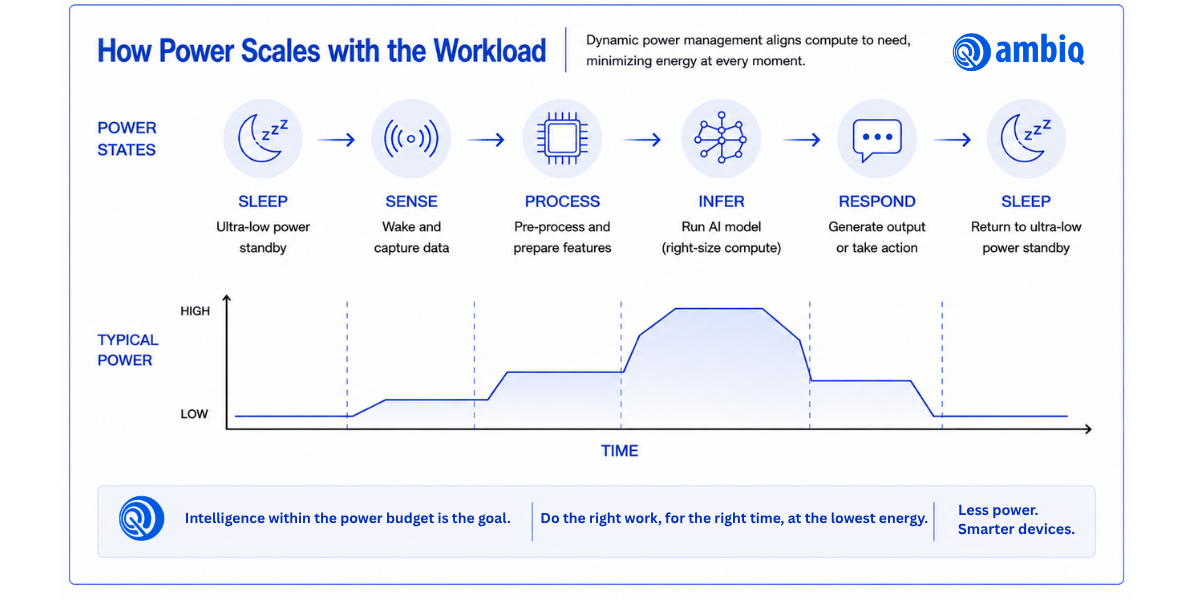
単一の動作点を中心に最適化されたアーキテクチャは、これらの遷移の過程において非効率になる可能性があります。
超低消費電力のウェアラブルデバイス向けには、ハードウェアは、ワークロードに応じて性能(ひいては消費電力)を調整できる必要があります。
AmbiqのSPOTアーキテクチャは、この原則に基づいて構築されています。turboSPOT®などの技術は、超低消費電力動作を実現するように設計されたアーキテクチャを維持しながら、ワークロードの要求に応じて高い処理性能を実現することができます。ウェアラブルAIのワークロードが拡大するにつれ、この原則の重要性はさらに高まっています。
Ambiqの次世代アーキテクチャAtomiq™は、その超低消費電力アプローチを専用のニューラル処理へと拡張しています。Atomiqは、SPOTテクノロジーとArm® Ethos™-U85 NPUを組み合わせることで、200 GOPSを超えるAI性能を実現します。 その動的電圧および周波数スケーリングアーキテクチャは、300 mV付近での動作向けに設計された超低消費電力モードを含む、超低消費電力、低消費電力、および高性能の各動作モードに対応するように設計されています。
重要な点は、プロセッサが単に高速に動作できるとか、極めて低い消費電力で動作できるということだけではありません。
重要なのは、ワークロードの変化に応じて、アーキテクチャがこれらの動作点の間を効率的に移行できるかどうかである
常時稼働のAIにおいて、これらの移行は、推論自体の効率と同様に、バッテリー寿命にとって重要な要素となり得ます。
4. メモリとデータの移動を見落とさない
AIチップのエネルギー効率に関する議論では、演算処理に多くの注目が集まります。しかし、演算を実行すること自体は、エネルギー消費のほんの一部に過ぎません。データをそこまで届ける必要があるのです。
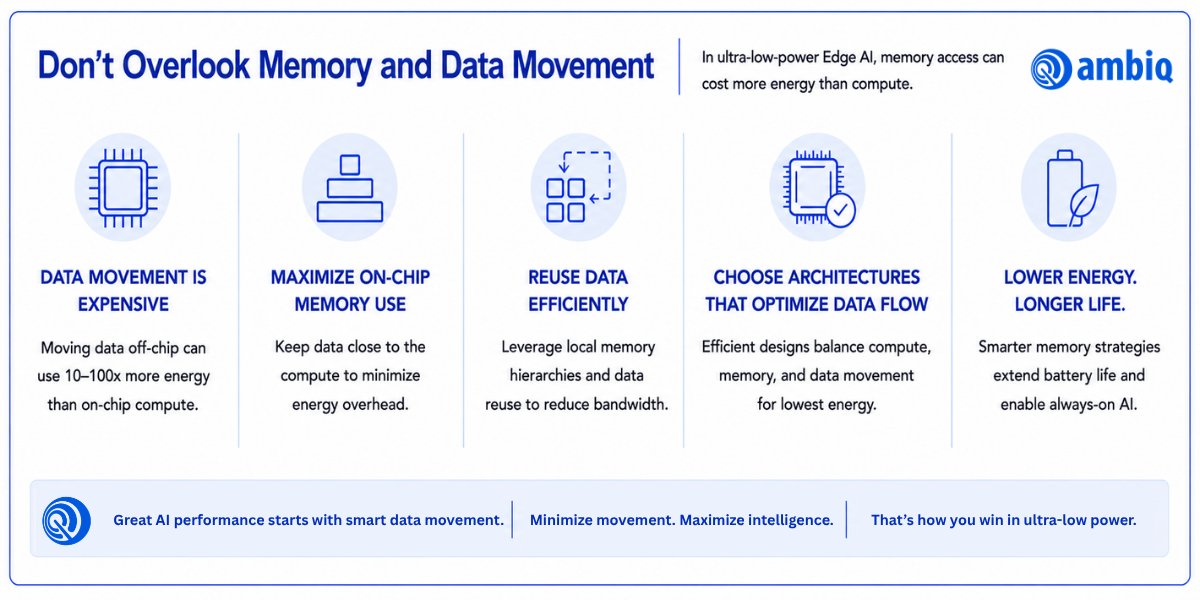
モデルの重み、センサー入力、中間アクティベーション、およびアプリケーションデータは、メモリと演算リソースの間を絶えず移動しています。こうした転送はエネルギーを消費します。メモリアーキテクチャの効率が悪い場合、データの移動によって、AI専用処理によってもたらされるメリットの一部が損なわれる可能性があります。
したがって、製品チームやエンジニアリングチームは、演算性能の仕様にとどまらず、以下の点についても検討するべきです:
- オンチップメモリの利用可能な容量
- メモリ帯域幅
- モデルおよび重みの保存
- データ保持
- メモリアクセスパターン
- メモリと演算リソースの近接性
モデルがより大規模かつ高度になるほど、こうした検討事項の重要性は高まります。
これはウェアラブルデバイスにおいて特に重要な点です。なぜなら、外部メモリを追加すると、消費電力、コスト、基板スペース、およびシステムの複雑さが増大する可能性があるからです。
したがって、効率的なオンデバイスAIとは、単に計算を効率的に行うことだけではありません。計算に必要なデータの移動や保存に必要なエネルギー量を削減することも重要な要素なのです。
5. AIアーキテクチャに常時センシング機能を組み込む
ウェアラブルAI体験の多くは、ニューラルネットワークが動作し始めるずっと前から始まっています。
デバイスは、何か意味のある事象が発生するのを待機している間、動作、音声、生理学的信号、環境からの入力、あるいはその他のセンサーストリームを継続的に監視する場合があります。
これらのタスクのために最高性能の処理リソースを継続的に稼働させると、エッジAIが持つバッテリー寿命の利点が急速に損なわれる可能性があります。
その代わりに、超低消費電力アーキテクチャを採用することで、デバイスは特定のタスクに必要なリソースのみをアクティブに保つことができるようになるでしょう。
より高性能な演算処理が低消費電力状態を維持している間に、軽量なセンシングおよび処理を実行することが可能です。高度な処理が必要なイベントが発生した場合、システムは追加のリソースを起動して処理を実行し、その後、低消費電力モードに戻ることができます。
この階層的なアプローチは、ウェアラブルコンピューティングにおいて特に重要です。なぜなら、常時稼働であっても、必ずしも最大性能で動作する必要はないからです。
極めて低い消費電力で有用な処理を実行し、必要に応じて選択的に演算能力を拡張できる能力は、小型のバッテリー駆動デバイスにおいて継続的インテリジェンスを実用化するための基盤となります。
6. ハードウェアとソフトウェアを組み合わせて評価する
高性能なシリコンは、開発者がその機能を効果的に活用できて初めて、価値を生み出します。
エッジAIの導入には、単にニューラルネットワークを動作させるだけでは不十分です。エンジニアリングチームは、モデルの変換、制約のあるハードウェアへの最適化、性能およびメモリ使用状況のプロファイリング、実際のセンサーパイプラインの統合、そしてシステムがどこでエネルギーを消費しているかを把握する必要があります。
したがって、AIソフトウェアスタックは、当初の段階からシリコン評価に組み込まれる必要があります。
Ambiqの neuralSPOT® SDK は、このハードウェアとソフトウェアの関係性を踏まえて設計されています。このSDKは、Apollo SoC上でAIモデルの開発、展開、チューニング、プロファイリングを行うための、オープンソースでリアルタイム、かつOSに依存しない環境を提供します。
エンジニアリングチームにとって、これは、開発環境で動作するモデルから、超低消費電力のエンドポイントにおける最適化された実装に至るまでのプロセスを短縮するのに役立ちます。
また、エッジAIにおいてますます重要になっている共同最適化という機能も可能にします。
開発者は、モデルとシリコンを別々に最適化する代わりに、ターゲットハードウェア上で、モデルアーキテクチャ、量子化、メモリ使用率、処理リソース、および動作モードがどのように相互作用するかを評価することができます。
厳しい制約のあるウェアラブルデバイスにおいては、これらの相互作用が重要となります。
モデルアーキテクチャやメモリの挙動におけるわずかな変更は、AIのピーク性能の大幅な向上よりも、全体的なエネルギー消費量に大きな影響を与える可能性があります。
7. エッジAIに合わせて拡張可能なアーキテクチャを選択する
ウェアラブルAIに求められる要件は急速に変化しています。
現在のデバイスでは、行動の分類やキーワード検出が必要とされるかもしれません。将来のデバイスでは、複数のセンサーに加え、より高度な音声処理、コンピュータビジョン、自然言語インタフェース、あるいはますます高性能化するオンデバイスAIモデルが組み合わされる可能性があります。
だからといって、すべての製品が、利用可能な最大規模のAIアクセラレータから始めるべきだというわけではありません。基盤となるプラットフォームには、拡張の余地が必要だということです。
Ambiqの製品ポートフォリオは、この進展を如実に示しています。
Apollo SoCは、組み込みおよびエッジAIワークロード向けに、超低消費電力の基盤を提供します。 Apollo510 は、多くのアプリケーションにおいてNPUを必要とすることなく、ますます高度化するAI向けに高性能な処理を拡張します。
大幅に強化された専用ニューラル処理の恩恵を受けるワークロード向けに、Ambiqが近日リリース予定の Atomiq ファミリーは、SPOTを超低消費電力の基盤として維持しつつ、NPUアクセラレーションを追加することで、アーキテクチャを拡張しています。
これにより、エッジAIコンピューティングに対して画一的なアプローチではなく、連続的なアプローチが提供されます。
ウェアラブル機器の設計者は、ほとんど使用されない性能のために電力やシステムコストを自動的に負担するのではなく、アプリケーションが実際に必要とする要件に基づいてアーキテクチャを選択することが可能になります。
ウェアラブル向けエッジAIチップを比較する際に確認すべきポイント
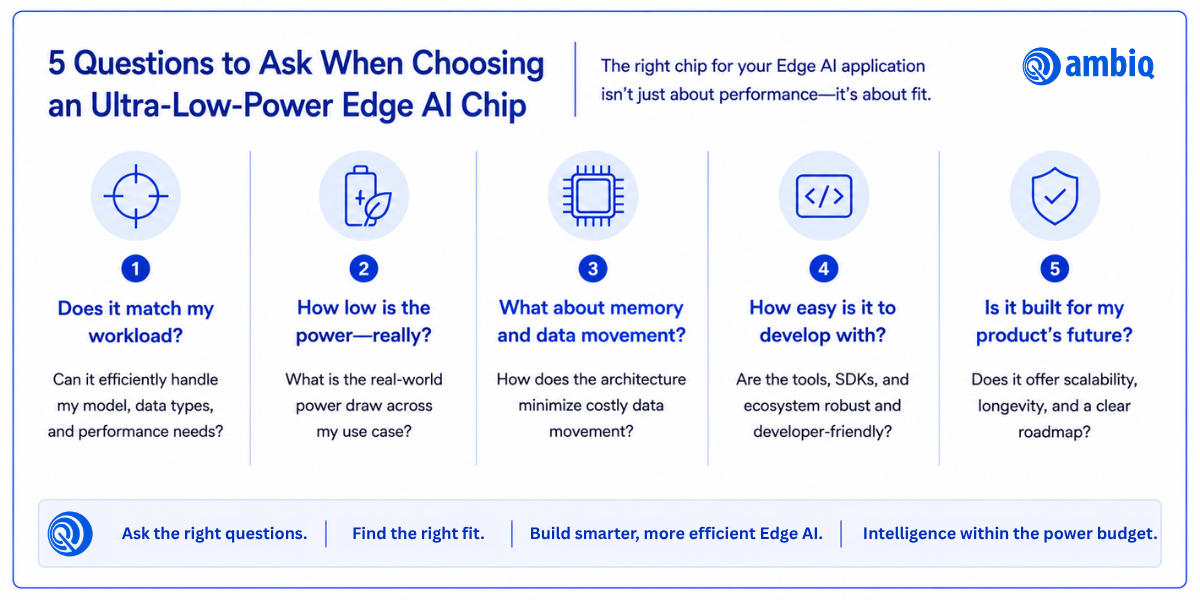
仕様書は候補を絞り込む上で有用ですが、超低消費電力のウェアラブル機器向けエッジAIチップを評価する際は、製品チームやエンジニアリングチームは仕様書だけにとどまらない検討を行う必要があります。
その目的は、実際のデバイスが直面する条件下で、各アーキテクチャがどのように動作するかを理解することにあります。
ワークロード全体のエネルギーコストはどれくらいか?
ベンダーには、センシング、前処理、メモリアクセス、AI推論、後処理、および動作状態間の移行を考慮した測定値を依頼してください。
アクセラレータのベンチマーク結果が優れているからといって、必ずしも全体的なウェアラブルデバイスの消費電力が低くなるわけではありません。
重要なのは、アプリケーション全体が実際のデューティーサイクルをを通じてどれだけのエネルギーを消費するかということです。
そのアプリケーションには、実際にNPUが必要か?
NPUは、十分に負荷の高いニューラルネットワークのワークロードに対しては極めて効果的です。しかし、必要のない場面で専用の演算機能を追加したり有効化したりすると、システムに不要な複雑さが生じる可能性があります。
どのワークロードがCPUやその他の利用可能な演算リソース上で効率的に実行できるか、また、専用のニューラル処理が性能やエネルギー効率の面で有意なメリットをもたらすのはどのような場合かを評価してください。
ウェアラブルAIの場合、その答えは、仕様書に記載されているアクセラレータの有無ではなく、ワークロードによって決定されるべきです。
このアーキテクチャは、各電源状態間をどの程度効率的に移動できるか?
ウェアラブル機器が、常にピークパフォーマンスで動作し続けることはめったにありません。
プロセッサが、必要なときにどれほど迅速かつ効率的に性能を向上させ、タスクが完了したら低消費電力状態に戻れるかを確認してください。
常時稼働するデバイスでは、これらの状態遷移の際に消費されるエネルギーが、バッテリーの総消費量に影響を与える可能性があります。
データの転送や保存にはどれだけのエネルギーが消費されているか?
AIのベンチマークでは、メモリが軽視される一方で、計算処理を重視する傾向があります。
モデルの重み、センサーデータ、および中間結果がシステム内でどのように流れるのか、また、頻繁に使用されるデータが、それを必要とする処理リソースの近くに保持できるかどうかを確認してください。
モデルが大規模になるにつれて、メモリアーキテクチャやデータの移動が、AIの総エネルギー消費量に占める割合をますます大きくする可能性があります。
開発者は、実際のモデルをハードウェア上でテストしたり、プロファイリングしたりできるか?
代表的なワークロードは、一般的なベンチマークよりも有用な情報を提供します。
エンジニアリングチームは、対象となる製品を忠実に再現したモデルやセンサーパイプラインを用いて、モデルのレイテンシ、メモリ使用量、演算リソース使用量、および消費電力の特性を評価できる必要があります。
ベンチマークが最終的なアプリケーションに近いほど、その結果はより有意義なものとなります。
AIの要件が変化しても、そのプラットフォームは拡張性を維持できるか?
現在のウェアラブルデバイスでは、センサーによる分類やキーワード検出が必要となる場合があります。将来の世代では、マルチモーダルセンシング、より高度な音声・映像機能、自然言語インタフェース、あるいはより高度なオンデバイスモデルなどが追加される可能性があります。
そのアーキテクチャが、初期の段階でそのデバイスを実用可能にする、エネルギー効率の原則を放棄することなく、AIの性能向上に向けた現実的な道筋を提供しているかどうかを確認してください。
これらの質問を総合すると、比較の対象が次のようなものから:
どのチップのAI数値が最も高いか?
以下のように移行します:
どのアーキテクチャなら、私のアプリケーションを最も効率的に実行できるか?
超低消費電力のウェアラブルAIにとっては、こちらの方がより適切な比較となります。
ベンチマークだけでなく、ワークロードもテストする
仕様書は、候補となるチップを絞り込むためのものですが、最終的な選択は、実際のワークロードに基づいて決定するべきです。
エッジAIプラットフォームを選定する前に、代表的なモデル、センサー入力、サンプリングレート、メモリ要件、および動作パターンを用いてテストを行ってください。
経路全体を測定します:
検知→ 前処理 → データ転送 → 推論 → 応答 → スリープ
これにより、推論レイテンシやアクセラレータの消費電力を個別に測定するよりも、ウェアラブルデバイスの消費電力について、より現実的な観点を提供します。
また、データシートからはわからないボトルネックを明らかにすることもできます。
アクセラレータはニューラルネットワークを極めて効率的に実行できますが、一方で、前処理やメモリ転送、あるいはシステムの起動にかかる時間が、総消費エネルギーの大部分を占めている場合があります。
したがって、最適なアーキテクチャが、必ずしも単独のAIベンチマークで優れた結果を出すとは限りません。
アプリケーションのワークロード全体を最も効率的に処理できるのが、最適なアーキテクチャです。
真のベンチマーク:電力バジェット内でのインテリジェンス
次世代のウェアラブルデバイスは、手首や指、耳、あるいは身体にどれだけのAI処理能力を搭載できるかという点だけで定義されるものではありません。
それは、限られたエネルギーでどれだけの有益なインテリジェンスを提供できるかによって定義されます。
そのため、超低消費電力のウェアラブル機器向けエッジAIチップを選定する際には、システム全体の消費電力、ワークロードに応じた演算処理、効率的なメモリ移動、常時稼働のセンシング、動的なパフォーマンススケーリング、およびハードウェアとソフトウェアの共同最適化が、極めて重要な検討事項となります。
Ambiqは、この課題に対して、電力アーキテクチャの観点からアプローチしています。
Ambiqの SPOTプラットフォーム は、超低消費電力の基盤を提供しています。 Apollo は、その効率性をウェアラブルクラスのエッジコンピューティングにもたらします。 neuralSPOT は、開発者がハードウェア向けにAIワークロードを構築・最適化するためのツールを提供します。モデルにより高い専用AIパフォーマンスが求められる中、 Atomiq は、その超低消費電力の理念をNPUベースのアーキテクチャにも拡張しています。
ウェアラブル製品およびエンジニアリングチームにとって、重要なポイントは単純明快です:
「チップがどれだけのAI性能を発揮できるか」を確認することから始めるべきではありません。デバイスのエネルギーバジェットから考え、その範囲内でアーキテクチャがどれだけのインテリジェンスを実現できるかを確認するべきです。
常時稼働のバッテリー駆動エッジAIにとって、これこそが考慮すべき基準です。